Study-Journal
综合指标
从此进入统计分析方法的学习
概念
综合指标分析法:用统计指标概括和分析现象总体数量特征和数量关系的方法
综合指标:用于反映现象总体的规模、数量对比关系和一般水平的综合性指标
分类
-
总量指标 – 反映社会经济现象在一定时间、地点、条件下的总规模或总水平
-
相对指标 – 用两个有联系的指标数值对比所形成的比率,反映社会经济现象间数量对比关系和联系程度
-
平均指标 – 表明同类社会经济现象在一定时间、地点、条件下所达到的一般水平
-
标志变异指标 – 反映总体各单位标志值的离散状况或变异程度,以平均差异形式作为平均指标的补充存在
第一节 总量指标
一、总量指标的概念和作用
(一)概念
又称绝对指标或统计绝对数,一般用绝对数表示,是最基本的统计指标
统计收集整理阶段能得到的指标数据只有总量指标
因此,以外的三种指标也称作派生指标
一般情况下,总量指标的数值和研究范围同向变动,即变动研究范围一定会使总量指标数值同向跟随变化,这也是判断总量指标的重要依据之一
例外:利润不一定会和研究范围同向变动(存在负值)
但在单选题不作为仍然以同向变动为准
这很现实
(二)作用
-
是认识社会经济现象的起点
-
是实行社会经济管理的依据之一
-
是计算相对指标、平均指标的基础
二、总量指标的种类
(一)按所反映的内容不同
-
总体单位总量 – 总体总量
用来反映统计总体内包含总体单位个数多少的总量指标,可以表明总体的容量大小
-
总体标志总量 – 标志总量
是统计总体各单位某一方面标志值的总和
对于一个确定的总体,总体单位总量只有一个,总体标志总量可以有多个
随着研究目的的变化,二者之间可以相互转化
研究某市工业企业经营状况
总体单位总量:工业企业的数量
总体标志总量
所有工业企业职工人数之和
产值之和
利润之和等等
当研究目的发生变化,如改为研究某市工业企业职工素质情况
- 总体单位总量:所有工业企业职工人数之和
(二)按所反映的总体时间状况不同 *重点
-
时期指标 – 时期数
反映总体现象在一定时间内累计总量水平,反映社会经济现象总体在一段时间内发展过程的总结果,又称流量指标
经济现象中常见的总量指标大多都是时期指标 – 销量、利润、产值等等
-
时点指标 – 时点数
反映总体现象在某一时点或时刻所达到的规模或水平,会随着时间的变化产生波动,又称存量指标
表现为常用期初/期末等词修饰特指 – 月底设备数量、年初职工人数、售前产品库存
时期指标和时点指标的区别
可加性
- 前者反映一段时间内,后者某一时点,因此只有前者具备可加性
指标值大小与时期关系
- 前者连续累计,累计结果有实际意义,数值大小和时期长短有直接关系
一般来讲同向变化,例外依然是负值导致,如利润
- 后者累计结果没有实际意义,数值大小和时期长短没有直接关系
数据获取的方式
时期指标 – 经常性调查
时点指标 – 一次性调查获得
注意:死亡人口数和出生人口数这类和人口数不同,属于时期指标
(三)按总量指标计量单位不同
-
实物指标 – 直观具体,但不可相加,综合性差
以根据事物的外部特征和物理属性确定的单位计算的总量指标,又称实物单位,主要包括
-
自然单位 – 实物本身用来计量:一个人、一棵树
-
度量衡单位 – 已经确定出的标准计量
-
复合单位 – 两个单位结合计量:人均 GDP(GDP/人数)
-
标准实物单位 – 按固定折算标准度量被研究现象数量:煤以 1 公斤 7000 公斤为标准发热量
-
-
价值指标
以货币为单位计算的总量指标,又称价值单位,是最常见的计量单位
代表一定的社会必要劳动量,具有最广泛的综合性和概括性,但比较抽象
-
劳动指标
以劳动时间为单位计算的总量指标,又称劳动单位
把劳动者数量和劳动时间结合的产物,如工日、工时等
工日 = 劳动人数 × 劳动时间
如 1000 工日 = 1 人 × 1000 天 = 1000 人 × 1 天
主要在企业范围内使用,尤其是产品品种较多,零件复杂多样的机械制造企业使用较多
第二节 相对指标
一、相对指标概述
(一)概念
也称统计相对数,表现为发展程度、结构、强度、普遍程度或比例关系等
把两个对比的具体数值概括化或抽象化,使人们对事物有一个清晰的概念
(二)作用
-
具体表明社会经济现象之间的比例关系
-
使一些不能直接对比的事物找出共同比较的基础
比较企业获利能力时,直接比较利润并不科学,一般比较资金利润率即 $\frac{资金}{利润}$
(三)表现形式
-
有名数
将对比的分子指标和分母指标的计量单位结合使用,以表明事物的密度、普遍程度和强度等 – 元/人
六大类中,只有强度相对指标会出现有名数
-
无名数
一种抽象化的数值,一般分为系数、倍数、百分数、千分数等 – 资金利润率
分子数值与分母数值相差很大时,可用倍数
成数是将对比的基数作为 10
百分数是将对比基数作为100,是相对指标中最常用的形式,分子分母数值接近时宜用
千分数是将对比基数作为 1000,使用于分子比分母小得多的情况
二、相对指标的种类和计算方法
(一)计划完成程度
1. 概念
是在某时期实际完成值和计划完成值对比的结果,一般用百分数表示
公式为
\[计划完成程度相对数=\frac{实际完成值}{计划完成值}\times 100\%\]分子项数值减去分母项数值的差额表示执行计划的绝对效果
因为正指标和逆指标的存在,计划完成程度相对数大于 100% 并不一定代表超额完成
正指标(数值越高越好)
实际大于计划 -> 大于 100% -> 超额完成
实际小于计划 -> 小于 100% -> 未完成
逆指标(数值越低越好)
实际大于计划 -> 大于 100% -> 未完成
实际小于计划 -> 小于 100% -> 超额完成
2. 计算
-
根据总量指标计算 – 直接代入公式
-
根据相对指标计算
有些计划任务数是以提高率或降低率表示,此时以基数 1 即 100% 来代入公式
\[提高率计划完成程度相对数=\frac{1+实际提高率}{1+计划提高率}\times 100\%\] \[降低率计划完成程度相对数=\frac{1-实际降低率}{1-计划降低率}\times 100\%\] \[绝对效果=相对数-100\%\]
3. 作用
-
可以准确说明各项计划指标的完成程度,为搞好经营管理提供依据
-
可以反映计划执行进度,以便及时发现问题、提出措施,推动经济建设良好发展
以时间进度比值和计划完成程度相对数比较,可以判断计划执行超前还是滞后
属于常识很多人有意无意都已经在用这个方法了 -
可以反映计划执行过程中的薄弱环节,为组织新的平衡提供依据
(二)结构相对数
1. 概念
在分组的接触上,总体区分为不同性质(即差异)的各部分,以部分数值与总体全部数值对比而得出的比重,来反映总体内部组成状况
公式为
\[结构相对数=\frac{总体部分数值}{总体全部数值}\times 100\%\]-
一般用百分数、成数或系数来表示,各组比重总和等于 100%
-
其分子分母可以同是总体单位数,也可以同是总体的标志数值,分子的数值是分母数值的一部分
一般而言,分子分母不可互换
2. 作用
-
反映总体内部构成
-
根据不同时间的对比,可以反映内部发展趋势
-
反映资源利用程度及生产经营的好坏
(三)比例相对数
1. 概念
把同一总体中某部分数值与另一部分数值静态对比,用以反映总体范围内各个局部、各个分组之间的比例关系和协调平衡状态
公式为
\[比例相对数=\frac{总体中部分数值}{总体中另一部分数值}\]常用百分数来表示,也可以用比较基数单位为1、100、1000时被比较单位数是多少的形式来表示,可以连比,但项数不能过多
2. 作用
-
反映事物内部各部分之间的数量联系程度和比例关系
-
对国民经济的宏观调控具有重要意义
(四)比较相对数
1. 概念
又叫类比相对数,将不同地区(单位)之间的同类指标数值作静态对比得到的综合指标,表明事物在不同空间条件下的差异程度或相对状态
$\frac{甲企业劳动生产率}{乙企业劳动生产率}\times100\%$
公式为
\[比较相对数=\frac{某条件下的某类指标数值}{另一条件下的同类指标数值}\times100\%\]-
分子与分母指标的含义、口径、计算方法和计量单位必须保持一致
-
一般用百分数、倍数或者系数表示
-
可以是总量指标进行对比,也可以用相对指标和平均指标进行对比
-
分子和分母可以互换位置
比较相对数的必须要有可比性才有存在意义
如比较两企业销售收入,必须选定生产性能相近产品,生产规模相当的样本,才能计算比较相对数
2. 作用
- 解释现象之间的差异程度
(五)强度相对数
1. 概念
同一地区(单位)两个性质不同但有联系的总量指标数值对比得到的综合指标
人均GDP、人口密度、劳动生产率
公式为
\[强度相对数=\frac{某一总量指标数值}{另一有联系而性质不同的总量指标数值}\]-
有两种表示方法
-
一般用复名数表示,如
元/人,人/平方公里 -
少数用百分数或千分数表示,如资金利润率 $\frac{利润}{投入资金}\times100\%$
-
-
注意:强度相对数不是平均数
平均数
$平均工资=\frac{工资总额}{职工人数}=\frac{\sum每人的工资}{职工人数}$
-
分子分母必然有联系
-
分子是总体标志总量,分母是总体单位总量
-
分子分母相互对应,因此变动一方必然引起另一方的变化,否则结果没有意义
强度相对数
-
分子分母必然有联系
-
分子分母性质不同,变动一方不一定引起另一方的变化
-
同样的 GDP 无论对应多少人,算出的人均 GDP 总有意义
-
同理同样的一批人,无论产生了多少 GDP,都可以计算人均 GDP
-
-
6. 正逆指标
强度相对数的分子分母可以互换,通过互换分子分母得到的结果根据意义的不同分为正指标和拟指标两种
举例:某地商业网点密度
-
正指标:
零售商业机构数/人口数,每个人拥有的零售商业机构数,越高密度越高 -
逆指标:
人口数/零售商业机构数,每个零售商业机构服务人数,越低密度越高
强度相对数的分子分母互换位置,会引起指标性质的改变
3. 作用
-
可以用来比较不同的国家、地区、部门的经济实力或为社会服务的能力
-
可以从不同角度来反映和考核企业的经济效益
-
为国家和企业编制规划和管理角色提供参考依据
(六)动态相对数
同一现象在不同时期的两个数值进行动态对比得出的综合指标,表明现象在时间上发展变动的程度,通常用百分数或倍数表示,也称发展速度
本节唯一一个动态分析指标
公式为
\[动态相对数=\frac{报告期水平}{基期水平}\times100\%\]-
所研究的时期被称为报告期,也称计算期
-
作为对比标准的时间叫做基期
$\frac{2025年利润}{2024年利润}\times100\%$
三、正确运用相对指标的原则
(一)可比性原则
-
总体范围可比 – 以报告期总体范围为准,调整基期
-
计算方法和计算价格可比
-
指标包含的经济内容可比
-
计算时间、计算单位等方面可比
(二)相对指标和总量指标结合运用的原则
-
计算分子和分母的绝对差额
$增长量=报告期水平-基期水平$
-
计算每增长 1% 的绝对值
$增长1\%的绝对值=\frac{增长量}{(发展速度-1)*100}=\frac{基期水平}{100}$
(三)多种相对指标结合运用的原则
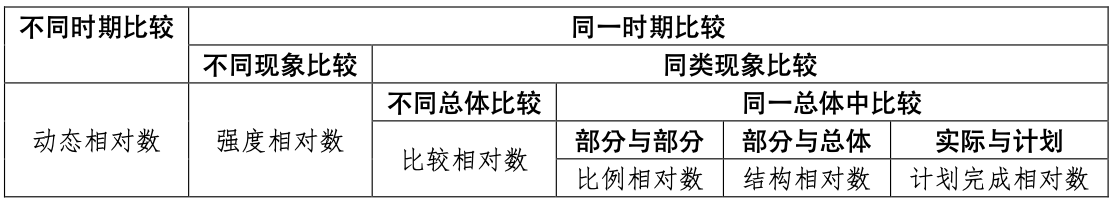
第三节 平均指标
一、概念
(一)概念
也称统计平均数,用以反映社会经济现象总体各单位某一数量标志在一定时间、地点、条件下所达到的一般水平
把总体各单位的标志值的差异抽象化,代表总体的集中趋势,可以用来比较同类现象在不同单位的发展状况
同质性是计算平均指标的根本前提
(二)分类
1. 数值平均数
指标大小和数据大小息息相关,会明显受极端值影响
-
算术平均数
-
调和平均数
-
几何平均数
2. 位置平均数
指标大小和数据大小无关,只取决于数据在本数列中的位置,不受极端值影响
-
众数
-
中位数
二、平均指标的特点及其作用
(一)特点
-
只能计算同类现象
-
将数量差异抽象化
-
反映总体变量值的集中趋势
(二)作用
-
对比一般水平,可以反映出各地区、单位工作的质量和效果
-
对比同一现象一般水平在不同时间的变化,可以反映这类现象发展变化的趋势及其规律性
-
分析现象之间的依存关系
-
进行数量估计推断
三、平均指标的计算
(一)算术平均数
分析社会经济现象一般水平和典型特征的最基本指标,是统计中计算平均指标最常用的方法,是总体标志总量除以总体单位数
1. 简单算术平均数
对应未分组数据
\[\bar X=\frac{X_1+X_2+...+X_N}{N}=\frac{\sum X}{N}\]2. 加权算术平均数
对应分组数据
如果掌握的资料经分组整理编成了单项数列或组距数列,并且每组次数不同时,应采用加权算术平均数的方法计算算术平均数
\[\bar X=\frac{X_1f_1+X_2f_2+...+X_Nf_N}{f_1+f_2+...+f_N}=\frac{\sum Xf}{\sum f}\]-
$f_i$:权数,即标志值出现的频数(每组单位数)
-
$X_if_i$:每组的标志总量
本质是以次数为权数计算算术平均,和加权平均数区分
特殊情况一:f 表现为比重时的公式推导
\[\bar X=\frac{\sum_1^N X_if_i}{\sum_1^N f_i}=\sum_1^N X_i\frac{f_i}{\sum_1^N f_i}=\sum X\frac{f}{\sum f}\]本质是以频率为权数计算算术平均,仍然应用同样的理论
特殊情况二:组距变量数列
$X_i$ 取各组的组中值进行计算
如下表
| 月奖金额 | 工人人数 |
|---|---|
| 40以下 | 10 |
| 40~50 | 10 |
| 50~60 | 30 |
| 60~70 | 30 |
| 70~80 | 10 |
| 80以上 | 10 |
| 合计 | 100 |
前提条件:假设变量在各组中均匀分布
因此所求结果只是近似值
$\bar X=\frac{\sum Xf}{\sum f}=\frac{35\times10+45\times10+55\times30+65\times30+75\times10+85\times10}{100}$
注意事项
慎重选择权数
数学性质
-
算术平均数与总体单位数的乘积等于总体各单位标志值的总和
-
各个标志值与算术平均数的离差之和等于零
-
受变量值直接影响
(二)调和平均数
引入
油菜价格早中晚分别为 5 4 2 元/千克
两人分别以每次一斤和每次一元的方式购入油菜,分析两人所花的平均价格
$\bar X_1=\frac{5\times0.5+4\times0.5+2\times0.5}{0.5+0.5+0.5}$ – 以数量为权数计算加权算术平均数
$\bar X_2=\frac{1+1+1}{\frac{1}{5}+\frac{1}{4}+\frac{1}{2}}$ – 即为调和平均数
又称倒数平均数了,是各个标志值倒数的算术平均数的倒数,一般用符号 $H$ 或 $\bar X_H$ 表示
1. 简单调和平均数
适用于各组标志总量相等时
\[\bar X_H=\frac{N}{\sum\frac{1}{X}}\]2. 加权调和平均数
适用于各组标志总量不等时
各组标志总量常用符号 $M$ 表示,$M=Xf$
\[\bar X_H=\frac{\sum M}{\sum\frac{M}{X}}\]不难看出,简单调和平均数是加权调和平均数 $\forall M_i=1$ 时的特殊形式
依然符合总体标志总量/总体单位总量的形式
3. 特点
-
如果数列中有一项标志值等于零,则无法计算 $\bar X_H$
-
若掌握了各组标志值和各组标志总量,未掌握各组单位数时,采用调和平均数计算平均指标
若掌握了各组标志值和各组单位数,应采用算术平均数计算平均指标
用引入举例:
已知价格和销量 -> 用算术平均
已知价格和销售额 -> 用调和平均
销售额=价格×销量 其实就是 $M=Xf$ 的具像化
-
调和平均数作为一种数值平均数,受所有标志值的影响,受极小值影响大于受极大值的影响
但相较于算术平均数,调和平均数受极端值的影响更小
4. 应用
-
往往作为算术平均数的变形来使用
二者仅计算过程不同,计算结果是相同的
$\bar X_H=\frac{\sum M}{\sum\frac{M}{X}}=\frac{\sum Xf}{\sum\frac{Xf}{X}}=\frac{\sum Xf}{\sum f}$
-
$m$ 是一种特定权数,不是各组变量出现的次数,而是各组标志总量,具有和算术平均数变量类似的性质
应用例
由相对数计算平均数
计算平均数计划完成程度时,如果只有实际完成数而没有计划数据,就应该采用加权调和平均数计算
工作计划完成程度(%) 实际工作量(M)(万元) 80~90 50 90~100 420 100~110 180 110~120 60 合计 710 $\bar X_H=\frac{\sum M}{\sum\frac{M}{X}}=\frac{50+420+180+60}{\frac{50}{85\%}+\frac{420}{95\%}+\frac{180}{105\%}+\frac{60}{115\%}}$
由平均数计算平均数
求平均单价
市场 平均单价(X)(元/千克) 销售额(元) 甲 1.50 3000 乙 1.20 3500 丙 1.60 4500 合计 — 11000 $\bar X_H=\frac{\sum M}{\sum\frac{M}{X}}=\frac{3000+3500+4500}{\frac{3000}{1.5}+\frac{3500}{1.2}+\frac{4500}{1.6}}$
(三)几何平均数
是 $n$ 个标志值连乘积的 $n$ 次方根
\[\bar X_G=\sqrt[n]{\prod_{1}^{n}{X_i}}=\sqrt[n]{\prod X}\]常用于动态数据的分析,因此在金融领域十分常见
如计算平均比率、平均发展速度等,且是计算平均发展速度的唯一方法
一位投资者持有一种股票,2014、2015、2016 年和 2017 年收益率分别为 4.5%、2.0%、3.5%、5.4%,计算这四年的平均收益率
(1) 假设 2013 股价是 a,则 2017 年股价是 $a\times104.5\%\times102\%\times103.5\%\times105.4\%$
(2) 设每年平均涨幅(即平均发展速度)是 $x=\frac{\sum x_i}{4}$,最终股价为 $a(1+x)^4$
联立 (1) (2),消去 $a$ 移项,得出和几何平均数完全一致的公式
特点
-
数列有一个是零,就无法计算
-
变量值为负数会形成虚根,失去意义
-
受变量值影响最小
-
较为少见
加权几何平均数
\[\bar X_G=\sqrt[\sum f]{\prod X^f}\]常用对数方法计算
\[\lg\bar X_G=\frac{\sum f\lg X}{\sum f}\]
(四)中位数和众数
位置平均,常见于数据偏斜极大的情况
1. 中位数
大小顺序排列后,位置在最中间的数值
特点
-
把标志值均等分为两部分
-
不受极端值影响,可以用来代替标志值的一般水平
-
在工业企业产品质量检查中经常用到
-
对某些不具有数学特点或不能用数学测定的现象,可用中位数求其一般水平(如颜色)
-
各单位标志值与中位数离差的绝对值之和为最小值
计算方法
资料未分组
项数为奇数 – 中间位置的标志值
项数为偶数 – 中间位置的两个标志值的算术平均数
资料分组
单项变量数列
计算中点位置 $\frac{\sum f}{2}$
根据中点位置对照累计次数确定中位数所在组
中位数所在组的标志值就是中位数
组距变量数列
计算中点位置 $\frac{\sum f}{2}$
根据中点位置对照累计次数确定中位数所在组
利用上下限公式计算中位数
上下限公式推导
设所在组下限是 $X_L$,上限是 $X_U$
若中位数所在组以前累积的变量个数是 $S_{m-1}$,之后累积的个数是 $S_{m+1}$
且该组有 $f_m$ 个变量
中点位置和前后累计个数之差比上该组变量数目就是中位数在该组前后的距离占比
距离占比分别乘组距 $i$ 得到的就是上下限得到的就是上下限到中位数的距离,进而结合上下限就可以求出中位数
下限公式
\[M_e=X_L+\frac{\frac{\sum f}{2}-S_{m-1}}{f_m}\times i\]上限公式
\[M_e=X_U-\frac{\frac{\sum f}{2}-S_{m+1}}{f_m}\times i\]本质是数学的差补法
2. 众数
整组数据出现次数最多的变量值
特点
-
可以直观说明客观经济现象中的集中趋势
次数分布曲线最高点对应的横坐标
-
不受极端值影响
-
对总体单位数有一定要求,且不具有唯一性
-
在组距数列中,当变量数列不等距分组时,众数的位置不好确定
-
如果只需要掌握一般、常见的标志值作为研究问题、安排工作时的参考,就可以采用众数
计算方法
资料未分组 – 略
资料分组
单项变量数列 – 出现次数最多的变量值即为众数值
组距变量数列
由最多次数确定众数所在组
利用比例插值法 推算 众数的近似值
比例插值法
下限公式
\[\frac{M_0-X_L}{i}=\frac{\Delta_1}{\Delta_1+\Delta_2}\] \[M_0=X_L+\frac{\Delta_1}{\Delta_1+\Delta_2}\times i\]上限公式
\[\frac{X_H-M_0}{i}=\frac{\Delta_2}{\Delta_1+\Delta_2}\] \[M_0=X_H-\frac{\Delta_2}{\Delta_1+\Delta_2}\times i\]
$\Delta_1$:所在组与前组次数之差
$\Delta_2$:所在组与后组次数之差
$X_H,X_L$:本组的上下限
$i$:组距
依然是数学的差补法
(五)相关统计指标的比较
在次数分布曲线上呈现
-
对称分布:均值=中位数=众数
-
钟形分布
-
左偏分布:均值<中位数<众数
-
右偏分布:均值>中位数>众数
-
第四节 标志变异指标
一、标志变异指标的概念和作用
(一)概念
-
反映总体各单位标志值离散状况或变异程度的指标
-
也称为标志变动度、离散程度或离中程度
(二)作用
-
是评价平均数代表性的依据
反向变动:变异程度越高,平均数越不具有代表性
-
反映经济活动过程的均衡性、节奏性或稳定性
-
可以揭示总体变量分布的离中趋势,是研究总体分布的重要特征值
-
可以确定推断总体的准确程度
二、标志变异指标的测定
常用的有
全距、平均差、标准差 – 反映变异绝对程度
平均差系数、标准差系数 – 反映变异相对程度
(一)全距
又称极差,指总体各单位值中最大值与最小值的差距
-
反映总体数据的变动范围
-
在组距数列中,全距的近似值就是最高组的上限与最低组的下限之差
(二)平均差
各单位标志值与其算术平均数的离差绝对值的算术平均数
1. 特点
-
是一种平均离差
-
能综合反映总体各单位标志值的变动程度
-
反映各标志值与算术平均数之间的平均差异
2. 计算方法
(1) 未分组
\[A.D.=\frac{\sum_1^N|X_i-\bar X|}{N}=\frac{\sum|X-\bar X|}{N}\](2) 分组
\[A.D.=\frac{\sum_1^N|X_i-\bar X|f_i}{\sum_1^N f_i}=\frac{\sum|X-\bar X|f}{\sum f}\]数学中,绝对值符号一旦添加很难去除,因此平均差的应用十分受限
为此,引入了伟大的标准差
唐突
(三)标准差
理念和作用同平均差一致,改进了计算方法
各单位标志值与其算术平均数的离差平方的算术平均数的平方根,又称均方差,通常用 $\sigma$ 和 $S.D.$ 表示
其平方即为方差,正对应了方差的符号 $\sigma^2$
1. 计算方法
(1) 未分组
\[S.D.=\sqrt{\frac{\sum_1^N(X_i-\bar X)^2}{N}}=\sqrt{\frac{\sum(X-\bar X)^2}{N}}\](2) 分组
\[S.D.=\sqrt{\frac{\sum_1^N(X_i-\bar X)^2f_i}{\sum_1^N f_i}}=\sqrt{\frac{\sum(X-\bar X)^2f}{\sum f}}\]等距变量数列标志值视为各组组中值
2. 特点
-
对整个标志值的离散趋势具有最充分的代表性
-
适用于任何方法的演算,应用不受限制
-
用标准差判断差异程度时
-
平均数相同的情况下,标准差越大,代表性越小;标准差越小,代表性越强
-
如果平均数不同,就不能用标准差来衡量
事实上,衡量绝对离散程度的三个指标都无法在被比较单位平均数不同时使用
为此,引入了标志变异系数
-
(四)标志变异系数
用于消除计量单位不同以及平均水平高低不一对离散程度判断的影响
重点注意计量单位不同也只能用标志变异系数衡量
1. 平均差系数
一单位均值对应的平均差的大小
\[V_{A.D.}=\frac{A.D.}{\bar X}\times100\%\]平均差用途受限,因此平均差系数也并不多见
2. 标准差系数
标志值离差的相对水平
\[V_\sigma=\frac{\sigma}{\bar X}\times100\%\]$100\%$ 也可以不加,即非必须作为百分数存在
-
标准差系数越大,数据离散程度越大,因而平均数代表性越小
-
标准差系数越小,数据离散程度越小,因而平均数代表性越大